1. Czym jest Azure Monitor?
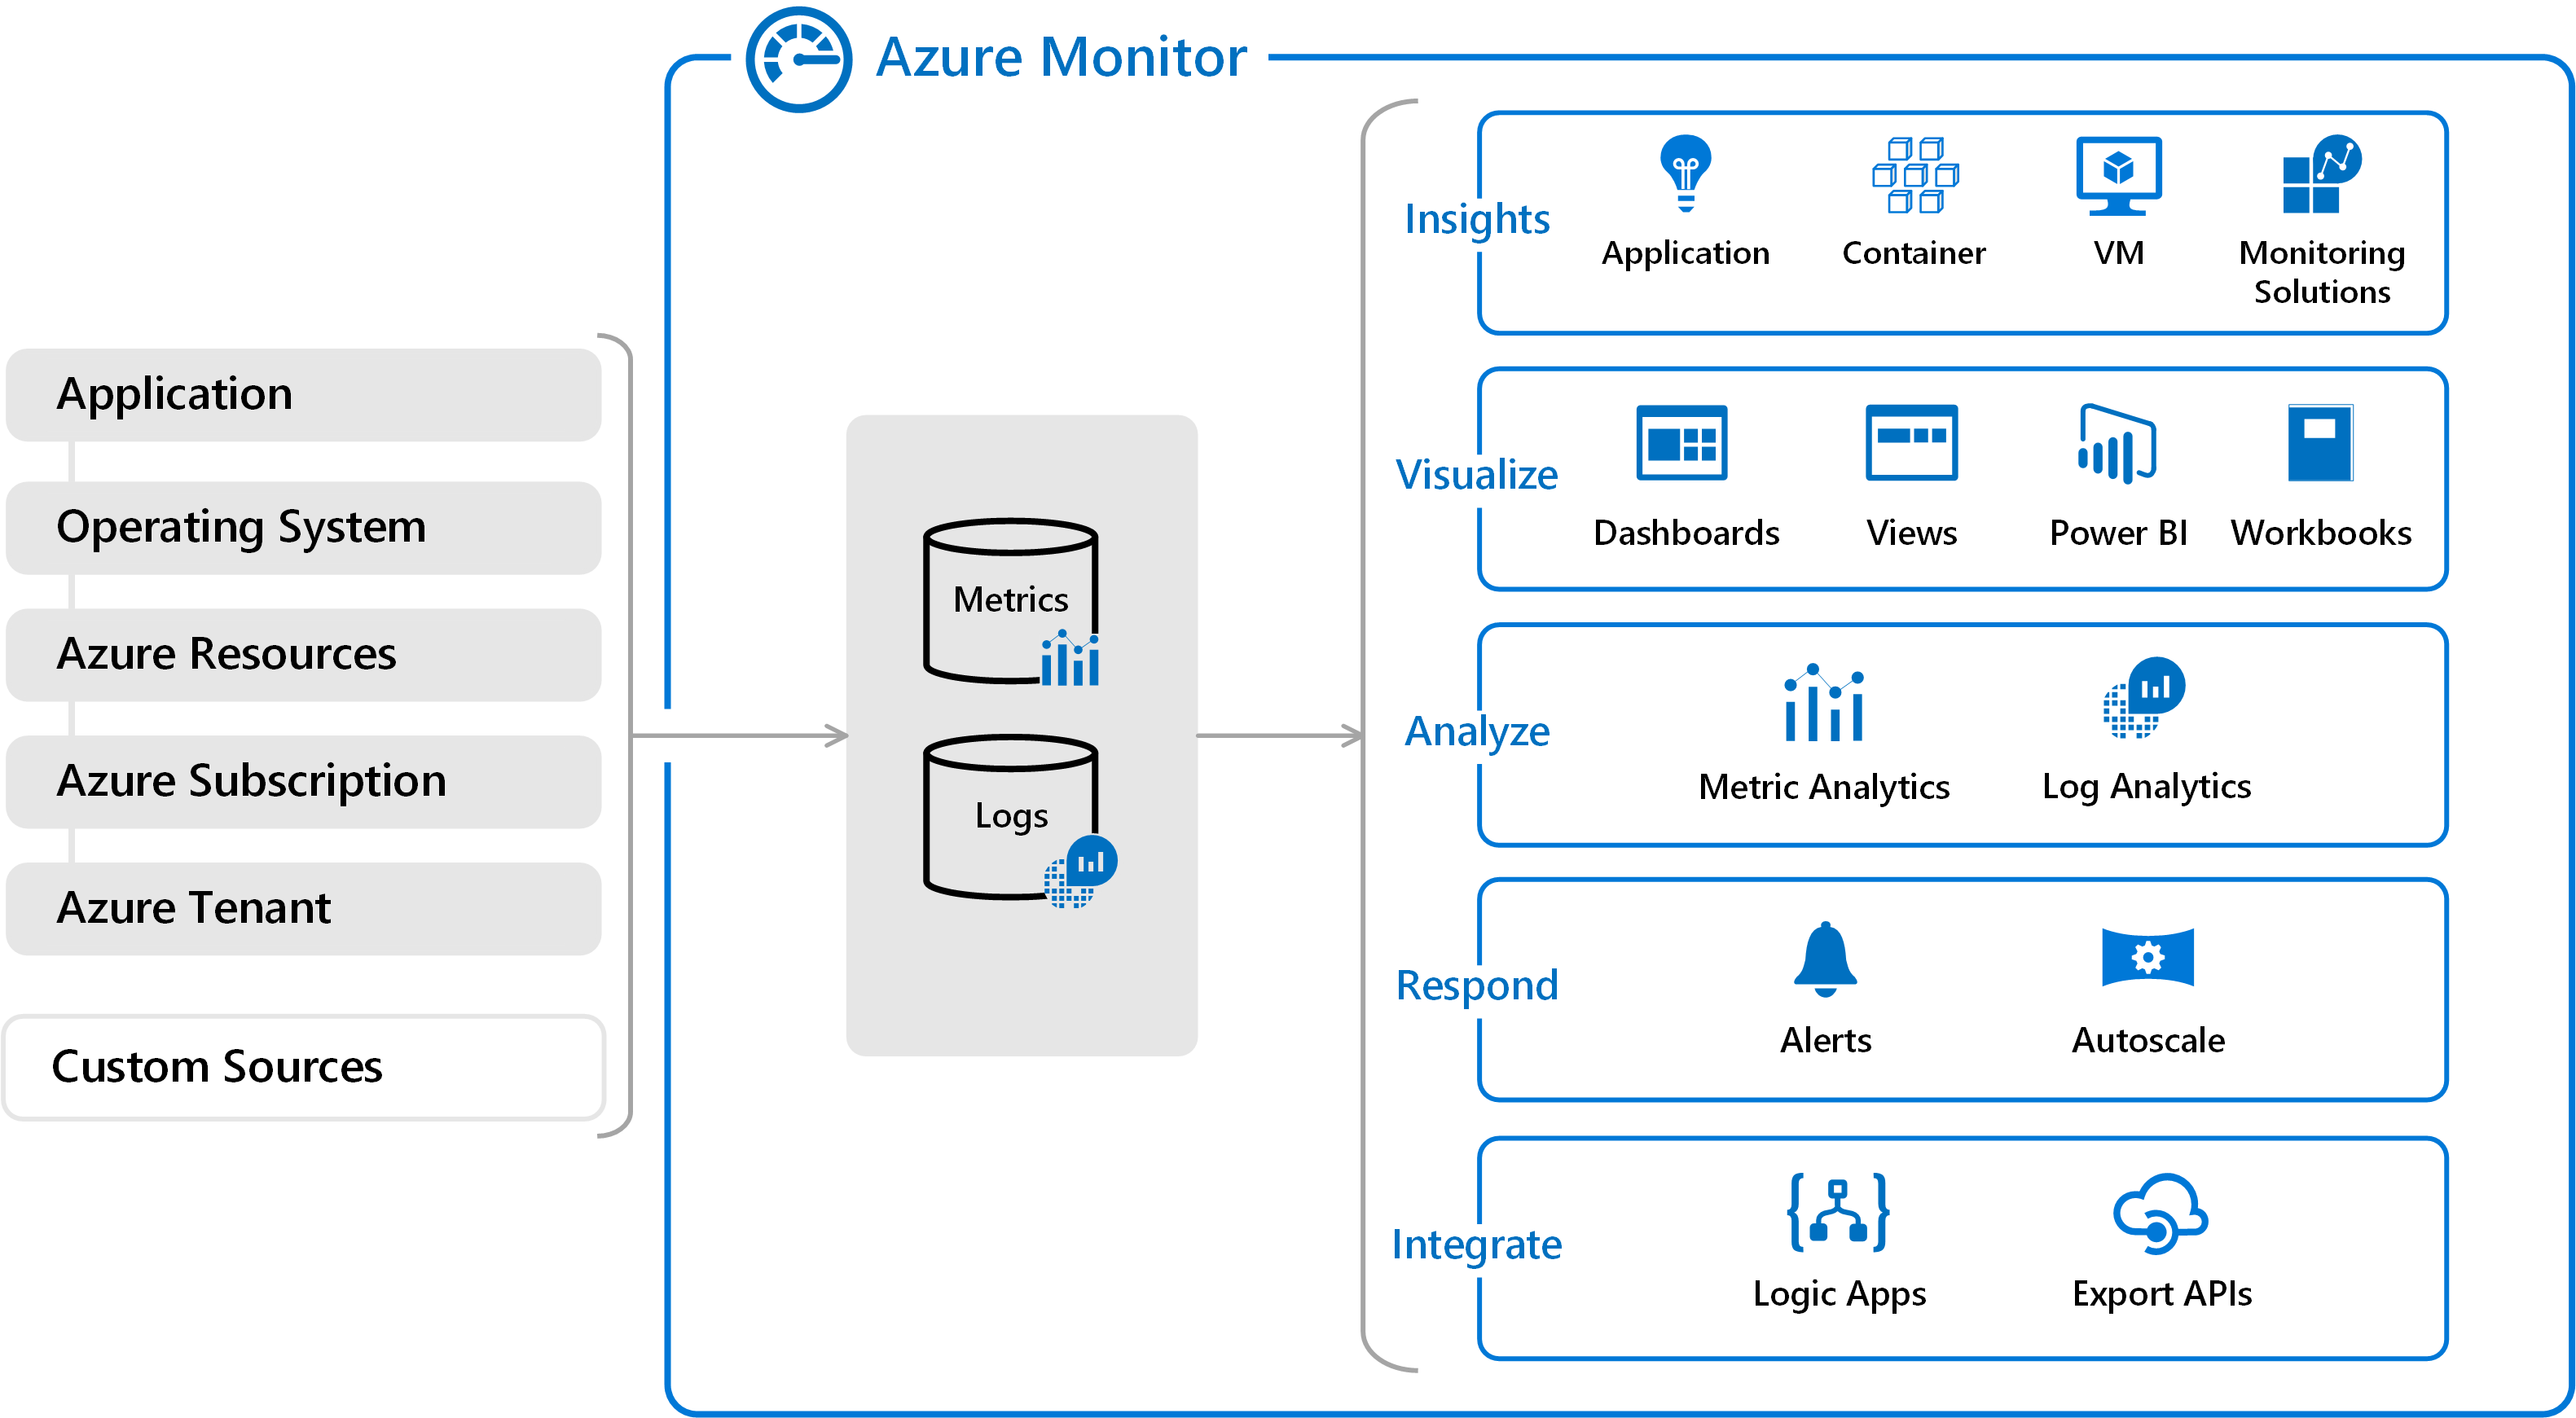
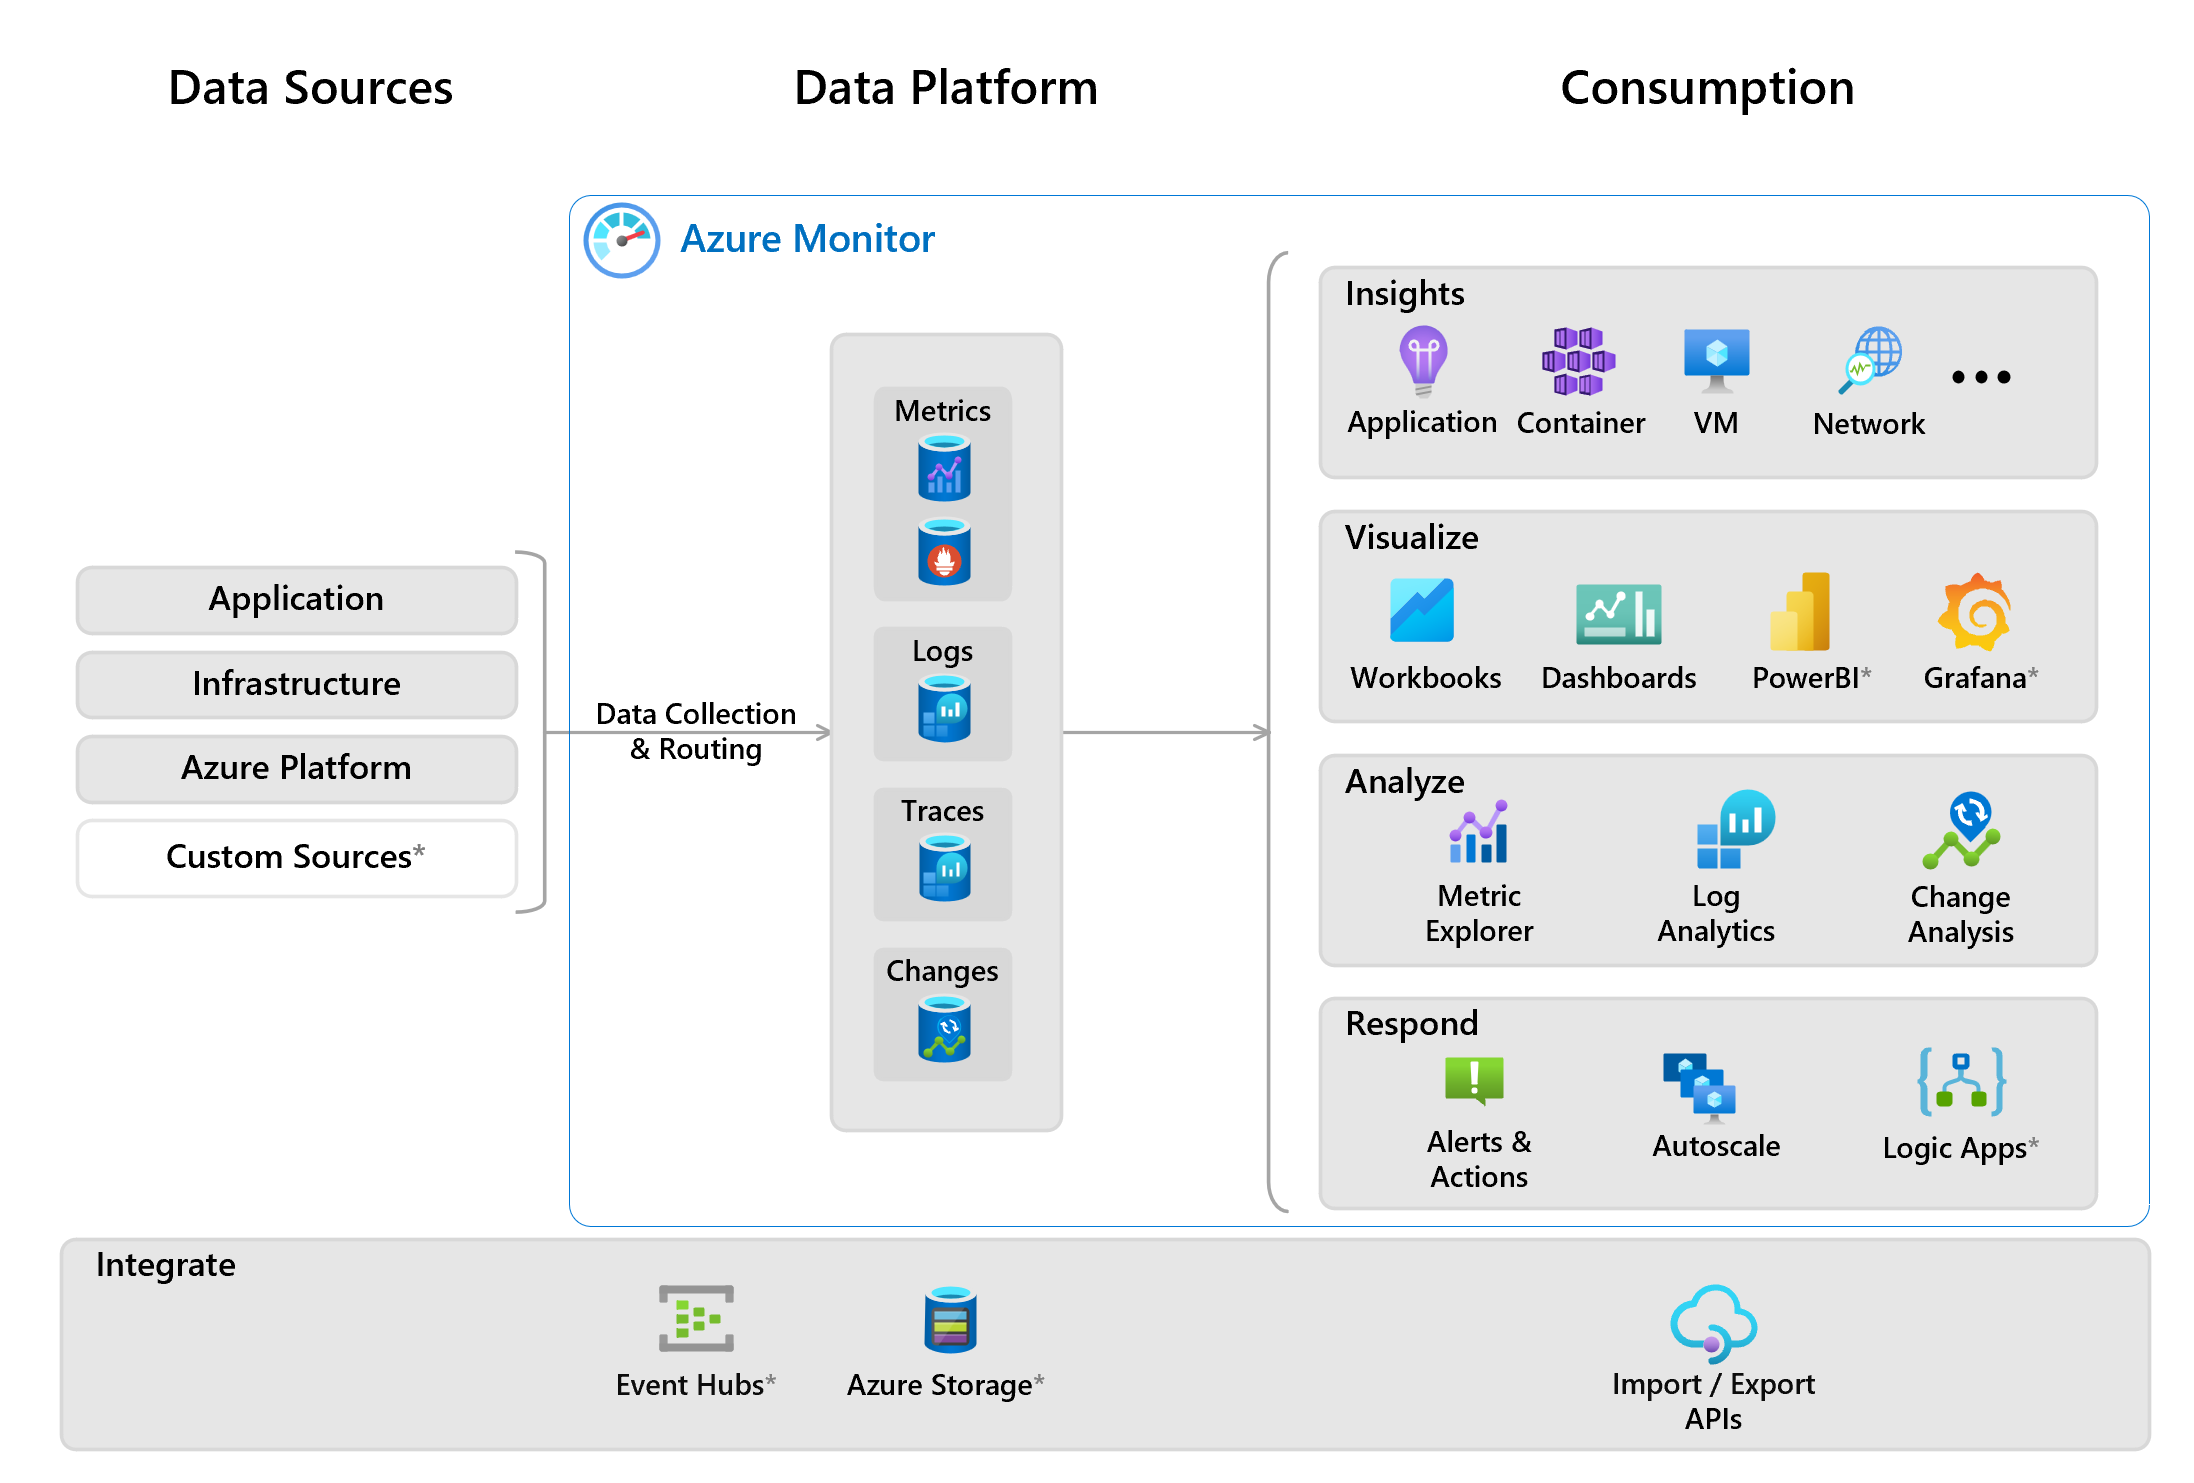
Azure Monitor to scentralizowana platforma obserwowalności w Microsoft Azure, która zbiera, analizuje i wykorzystuje metryki, dzienniki i ślady z zasobów Azure, aplikacji oraz infrastruktury.
Jego główne cele to:
- Widoczność – zrozumienie kondycji, wydajności i sposobu użycia
- Wykrywanie – identyfikowanie problemów, anomalii i sygnałów związanych z bezpieczeństwem
- Reagowanie – alertowanie, automatyzacja i integracja z narzędziami ITSM/SOC
- Optymalizacja – poprawa niezawodności, kosztów i wydajności
Zobacz diagram na learn.microsoft.com
Zobacz diagram na learn.microsoft.com
2. Typy danych w Azure Monitor
Azure Monitor pracuje z trzema podstawowymi typami danych:
Metryki
- Numeryczne dane szeregów czasowych
- Zbierane niemal w czasie rzeczywistym
- Lekkie i wydajne
- Idealne do alertowania i pulpitów nawigacyjnych
Przykłady:
- CPU Percentage (wykorzystanie procesora w procentach)
- Memory Usage (użycie pamięci)
- Request Count (liczba żądań)
- Disk Queue Length (długość kolejki dysku)
Przechowywane w: bazie metryk Azure Monitor (Azure Monitor Metrics Database)
Dzienniki
- Szczegółowe rekordy z możliwością wykonywania zapytań
- Przechowywane w obszarach roboczych Log Analytics (Log Analytics Workspaces)
- Odpytywane za pomocą języka Kusto Query Language (KQL)
Przykłady:
- Dzienniki aplikacji
- Dzienniki audytu
- Zdarzenia bezpieczeństwa
- Dzienniki niestandardowe
Przechowywane w: obszarze roboczym Log Analytics (zaplecze Azure Data Explorer)
Ślady
- Śledzenie żądań od początku do końca
- Używane głównie w aplikacjach
- Pokazuje zależności i opóźnienia
Przykłady:
- Czas trwania wywołania API
- Awarie zależności
- Przepływ transakcji rozproszonych
3. Podstawowe komponenty Azure Monitor
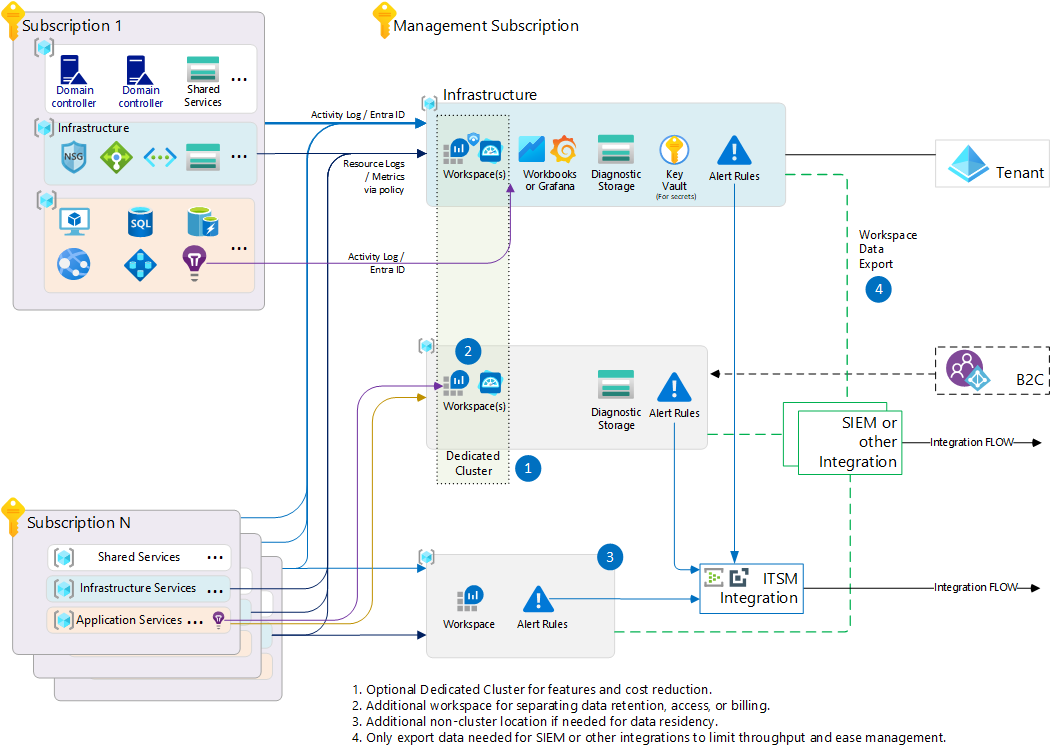
Zobacz diagram na learn.microsoft.com
Zobacz diagram na docs.azure.cn
3.1 Log Analytics Workspace
- Centralne przechowywanie dzienników
- Umożliwia zapytania KQL
- Wykorzystywany przez:
- Azure Monitor Logs
- Microsoft Sentinel
- VM Insights
- Container Insights
Typowe zastosowania:
- Dochodzenia w zakresie bezpieczeństwa
- Analiza przyczyn źródłowych
- Audyt zgodności
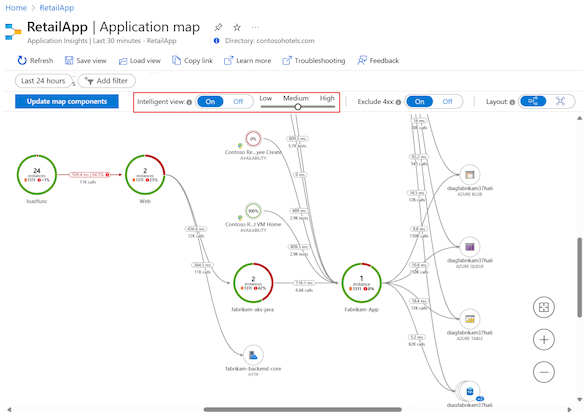
3.2 Application Insights
- Monitorowanie wydajności aplikacji (Application Performance Monitoring, APM)
- Skupia się na telemetrii na poziomie kodu
Kluczowe funkcje:
- Śledzenie żądań i odpowiedzi
- Monitorowanie zależności
- Analiza wyjątków
- Testy dostępności
Typowe obciążenia:
- .NET / .NET Core
- Java
- Node.js
- Python
- Azure Functions
- App Service
3.3 Azure Monitor Metrics
- Natywne metryki zasobów Azure
- Nie wymaga dodatkowego agenta
- Używane do szybkiego alertowania
Najlepsze do:
- Kondycji infrastruktury
- Decyzji o skalowaniu
- Monitorowania umów SLA
3.4 Diagnostic Settings
- Określają, jakie dane trafiają dokąd
- Wymagane do eksportowania dzienników i metryk
Miejsca docelowe:
- Log Analytics Workspace
- Event Hub
- Storage Account
4. Opcje alertowania
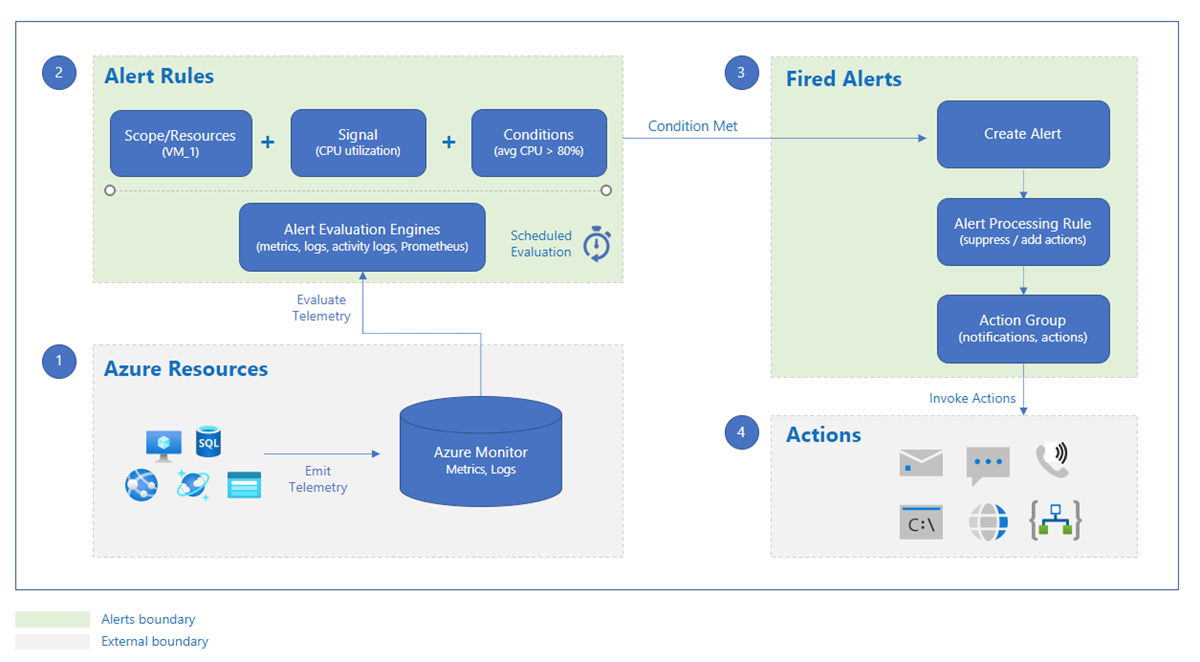
Zobacz diagram na learn.microsoft.com
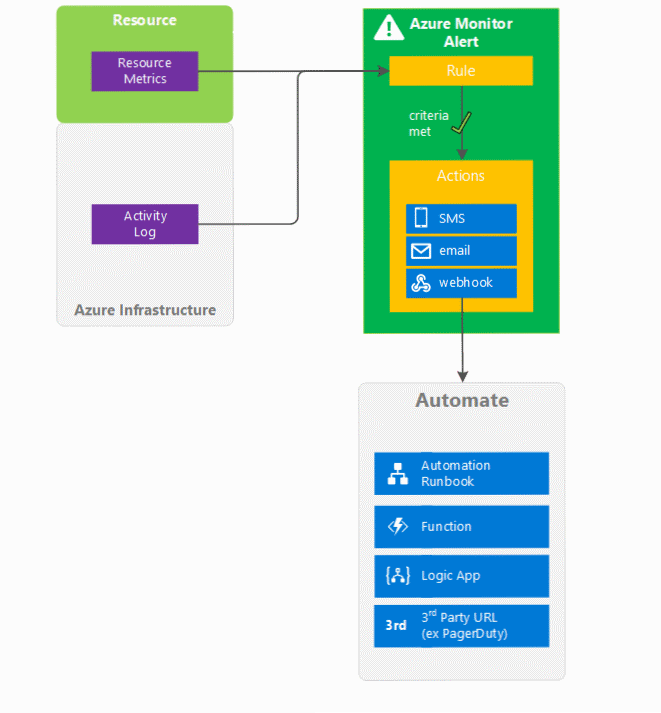
Zobacz diagram na docs.azure.cn
Azure Monitor obsługuje wiele typów alertów:
Alerty metryk
- Oparte na progach
- Szybkie (od sekund do minut)
- Idealne do monitorowania infrastruktury
Przykład:
CPU > 80% for 5 minutes
Alerty dzienników
- Oparte na zapytaniach KQL
- Potężne, ale wolniejsze niż alerty metryk
Przykład:
SecurityEvent
| where Level == "Error"
Alerty dziennika aktywności
- Zdarzenia na poziomie subskrypcji
- Monitorowanie płaszczyzny kontroli (control plane)
Przykłady:
- Usunięcie zasobu
- Zmiany zasad (policy)
- Modyfikacje RBAC
Smart Detection i alerty anomalii
- Oparte na AI
- Automatycznie wykrywają nietypowe zachowania
- W większości powiązane z Application Insights
5. Automatyzacja i integracje
5.1 Action Groups
Służą do określenia, co się dzieje po uruchomieniu alertu.
Obsługiwane akcje:
- SMS
- Połączenie głosowe
- Webhook
- Azure Logic App
- Azure Function
- ITSM (ServiceNow)
- Azure Automation Runbook
5.2 Azure Automation i Logic Apps
- Automatyczne usuwanie problemów (auto-remediation)
- Akcje skalowania
- Wzbogacanie incydentów
- Powiadomienia do Teams / Slack
6. Opcje zakresu monitorowania
Azure Monitor może monitorować:
Zasoby Azure
- Maszyny wirtualne (VM)
- App Services
- Azure SQL
- Konta magazynu (Storage Accounts)
- Load Balancers
- Azure Front Door
- Azure WAF
Środowiska hybrydowe i lokalne (on-premises)
- Za pośrednictwem Azure Monitor Agent (AMA)
- Windows i Linux
- Syslog i dzienniki zdarzeń Windows
Wiele chmur i systemy zewnętrzne
- Dzienniki niestandardowe przez API
- Pobieranie danych przez Event Hub
- Integracja z narzędziami SIEM/SOC
7. Koszty i przechowywanie danych
Główne czynniki kosztów:
- Wolumen pobieranych dzienników (GB/dzień)
- Okres przechowywania
- Eksport danych
- Ewaluacje alertów
Najlepsze praktyki:
- Filtruj dzienniki u źródła
- Stosuj retencję na poziomie tabel
- Tam, gdzie to możliwe, preferuj metryki
- Archiwizuj stare dzienniki w Storage
8. Kiedy czego używać (krótki przewodnik)
| Scenariusz | Zalecana funkcja |
|---|---|
| Kondycja maszyn wirtualnych | Metryki + alerty metryk |
| Wydajność aplikacji | Application Insights |
| Dochodzenie w sprawie bezpieczeństwa | Log Analytics |
| Audyt zgodności | Dzienniki + dzienniki aktywności |
| Automatyczne naprawianie (auto-healing) | Alerty + Logic Apps |
| Testy penetracyjne / analiza ataków | Dzienniki + dzienniki WAF |
9. Podsumowanie
Azure Monitor zapewnia:
- Ujednoliconą widoczność w Azure, aplikacjach i systemach hybrydowych
- Elastyczne alertowanie i automatyzację
- Dogłębną diagnostykę dzięki dziennikom i śladom
- Skalowalną architekturę odpowiednią dla obciążeń korporacyjnych
Jest fundamentem dla:
- Inżynierii niezawodności (SRE)
- Monitorowania bezpieczeństwa
- Optymalizacji wydajności
- Kontroli kosztów
Azure Monitor – praktyczne przykłady
WAF / Azure Front Door / App Service
(Przykłady dostosowane do obciążeń korporacyjnych / e-commerce / B2C)
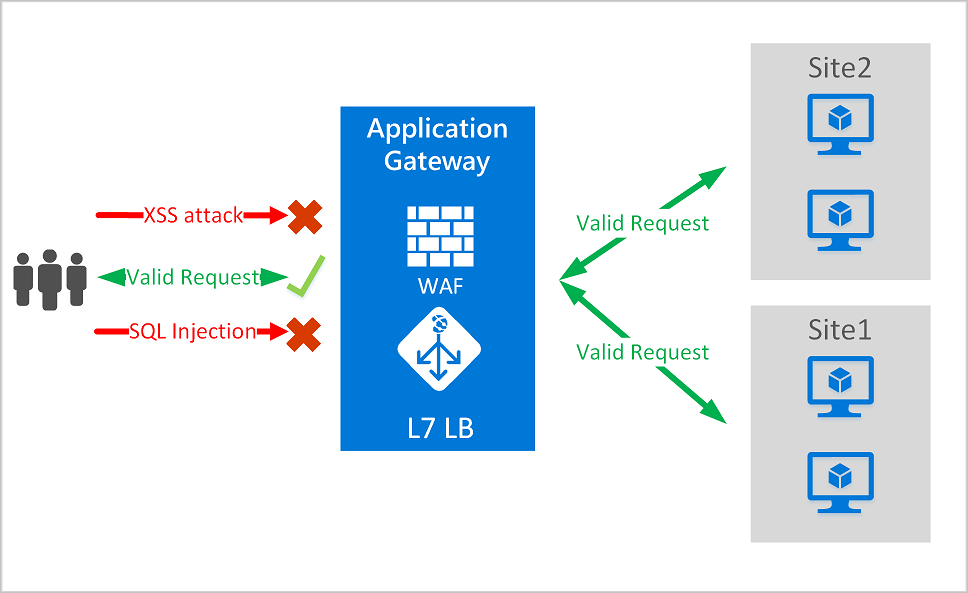
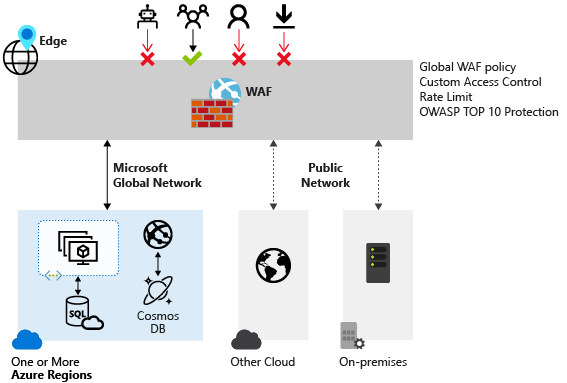
10. Monitorowanie Azure WAF (Front Door / App Gateway)
Zobacz diagram na learn.microsoft.com
Zobacz diagram na learn.microsoft.com
Co monitorować
Z diagnostyki Azure Web Application Firewall (WAF):
ApplicationGatewayFirewallLog(App Gateway)FrontDoorWebApplicationFirewallLog(Front Door)AzureDiagnostics(starszy)
Kluczowe sygnały:
- Żądania zablokowane a dozwolone
- Trafienia reguł OWASP
- Reputacja adresów IP i ruch botów
- Anomalie geolokalizacji
- Fałszywe alarmy z legalnych zwrotnych serwerów proxy (reverse proxy)
Przykład: nagły skok liczby zablokowanych żądań
Scenariusz:
Ponad 4000 żądań zablokowanych w krótkim oknie czasowym, wszystkie pochodzące ze znanego zwrotnego serwera proxy partnera.
KQL – przegląd zablokowanych żądań
AzureDiagnostics
| where Category == "FrontDoorWebApplicationFirewallLog"
| where action_s == "Block"
| summarize Count = count() by clientIP_s, ruleName_s, bin(TimeGenerated, 5m)
| order by Count desc
Co to Ci mówi:
- Które adresy IP są blokowane
- Które reguły OWASP zostały uruchomione
- Czy to ruch atakujący, czy fałszywy alarm
Przykład: analiza reguł OWASP
AzureDiagnostics
| where Category == "FrontDoorWebApplicationFirewallLog"
| summarize Hits = count() by ruleSetType_s, ruleId_s, action_s
| order by Hits desc
Zastosowanie:
- Dostrajanie wykluczeń WAF
- Decyzja, czy reguła powinna działać w trybie Log zamiast Block
Zalecane alerty
- 🚨 Zablokowane żądania > X/min
- 🚨 Wykryto nowy kraj źródłowy
- 🚨 Skok trafień reguły 942100 / 930120 (SQLi / RCE)
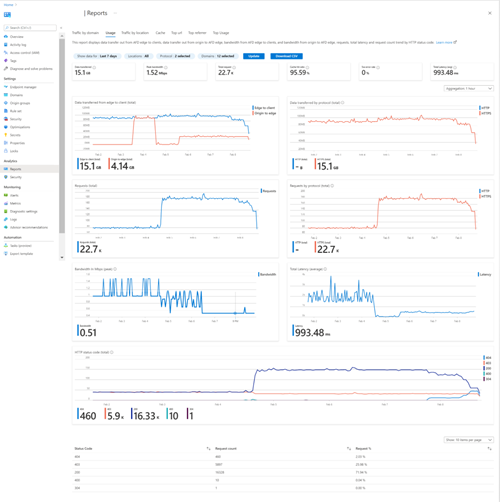
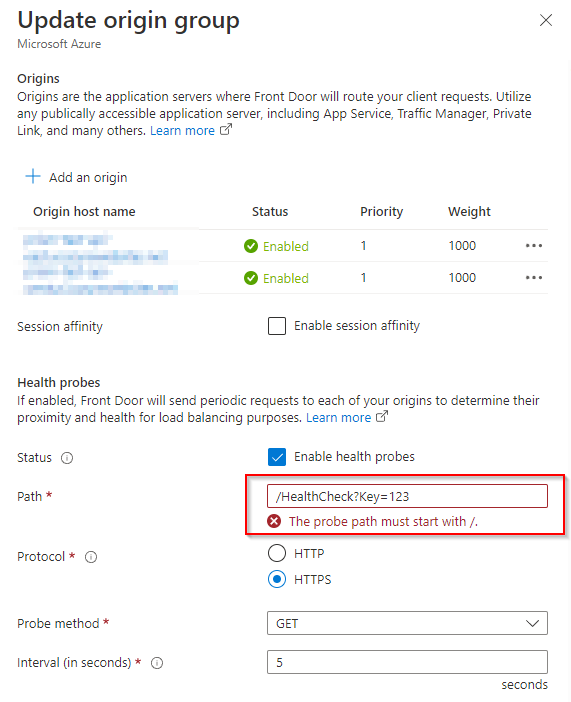
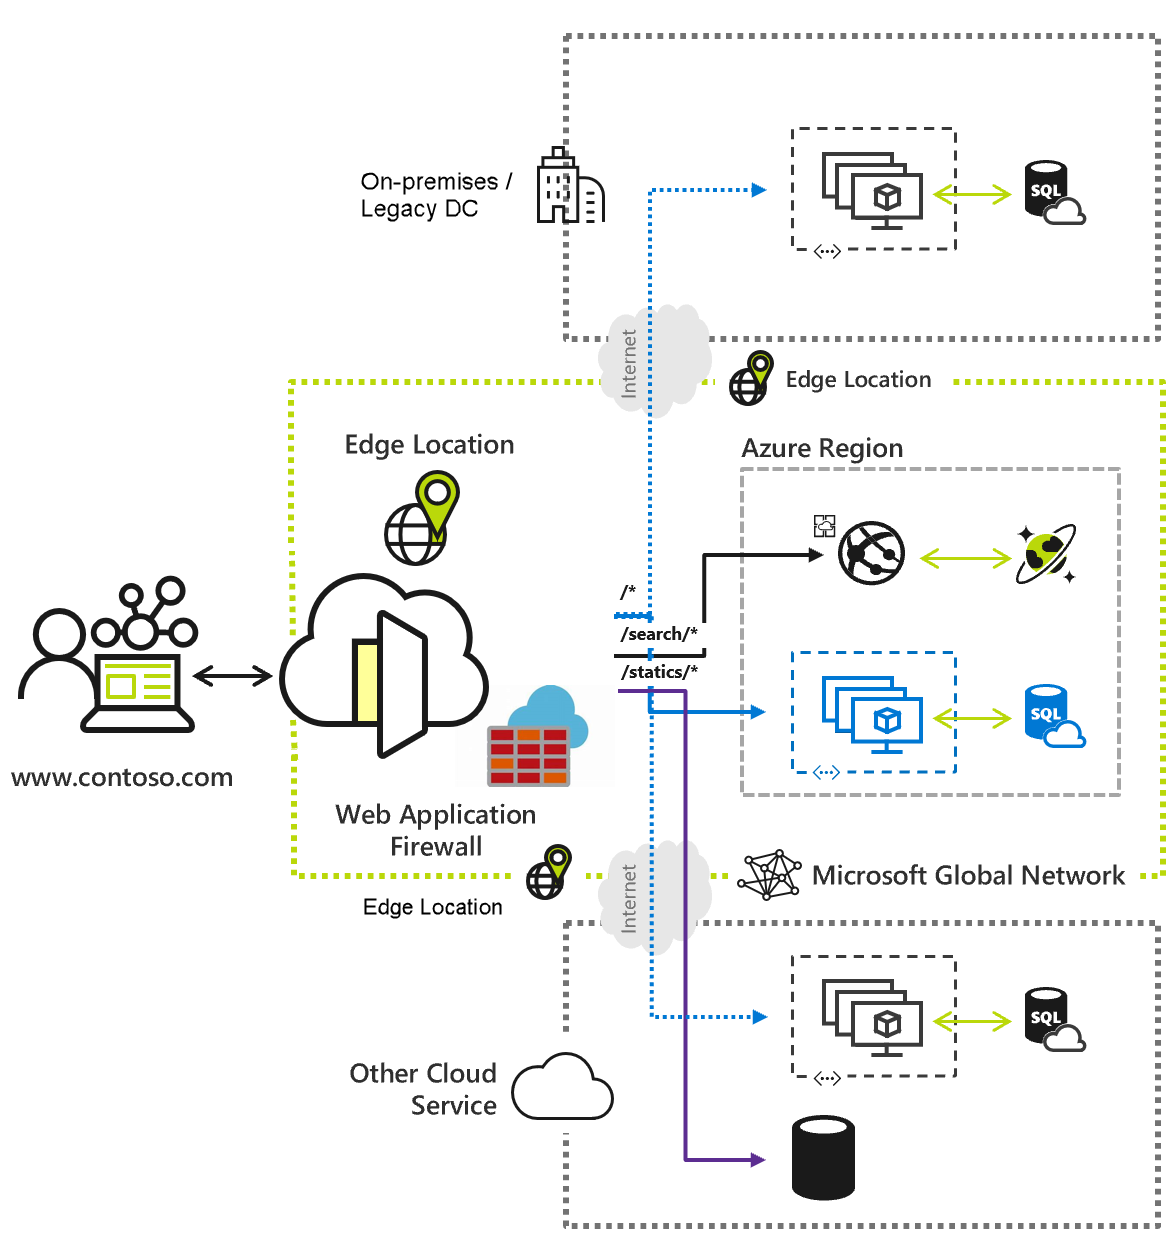
11. Monitorowanie Azure Front Door
Zobacz diagram na learn.microsoft.com
Zobacz diagram na learn-attachment.microsoft.com
Zobacz diagram na learn-attachment.microsoft.com
Metryki do włączenia
Z metryk Azure Front Door:
- Backend Health Percentage (procent kondycji zaplecza)
- Total Requests (łączna liczba żądań)
- Failed Requests (nieudane żądania)
- Latency (TTFB) (opóźnienie)
- WAF Blocked Requests (żądania zablokowane przez WAF)
Przykład: spadek kondycji zaplecza
Alert metryki
BackendHealthPercentage < 90% for 5 minutes
Grupa akcji (Action Group):
- Powiadomienie zespołu operacyjnego
- Uruchomienie Logic App
- Weryfikacja automatycznego przełączenia awaryjnego (failover)
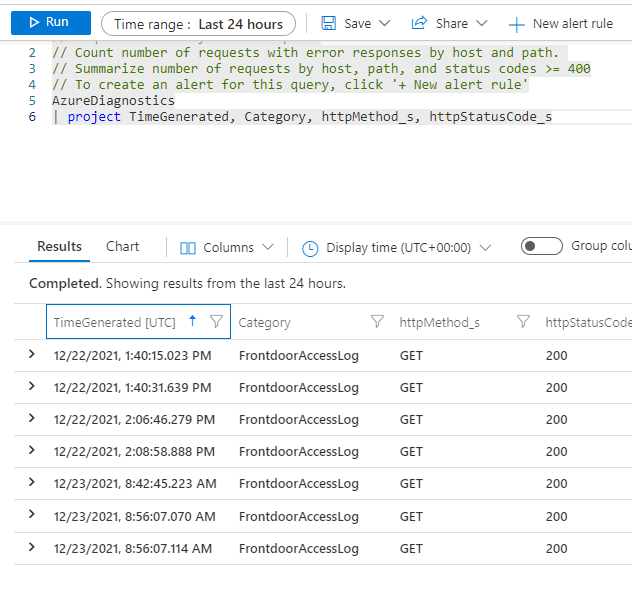
Przykład: dzienniki dostępu Front Door – wysokie opóźnienie
AzureDiagnostics
| where Category == "FrontDoorAccessLog"
| summarize AvgLatency = avg(timeTaken_s) by backendPoolName_s
| order by AvgLatency desc
Zastosowanie:
- Wykrywanie wolnych zapleczy
- Porównywanie regionów (UE a USA)
- Wsparcie decyzji o routingu w ramach planów ciągłości działania (BCP)
Przykład: podział źródeł ruchu
AzureDiagnostics
| where Category == "FrontDoorAccessLog"
| summarize Requests = count() by clientCountry_s
| order by Requests desc
Zastosowanie:
- Nieoczekiwany ruch z danych regionów geograficznych
- Wzorce DDoS lub botów
- Planowanie pojemności
12. Monitorowanie Azure App Service
Zobacz diagram na learn.microsoft.com
Zobacz diagram na learn.microsoft.com
Zobacz diagram na learn.microsoft.com
Metryki (szybkie alerty)
- CPU Percentage (wykorzystanie procesora w procentach)
- Memory Working Set (zestaw roboczy pamięci)
- Błędy HTTP 5xx
- Żądania na sekundę
- Czas odpowiedzi
Przykład: skok użycia CPU bez wpływu na wydajność
Alert metryki
CPU > 80% for 10 minutes
Interpretacja:
- Aplikacja może nadal być zdrowa
- Skoreluj z opóźnieniem żądań i odsetkiem błędów
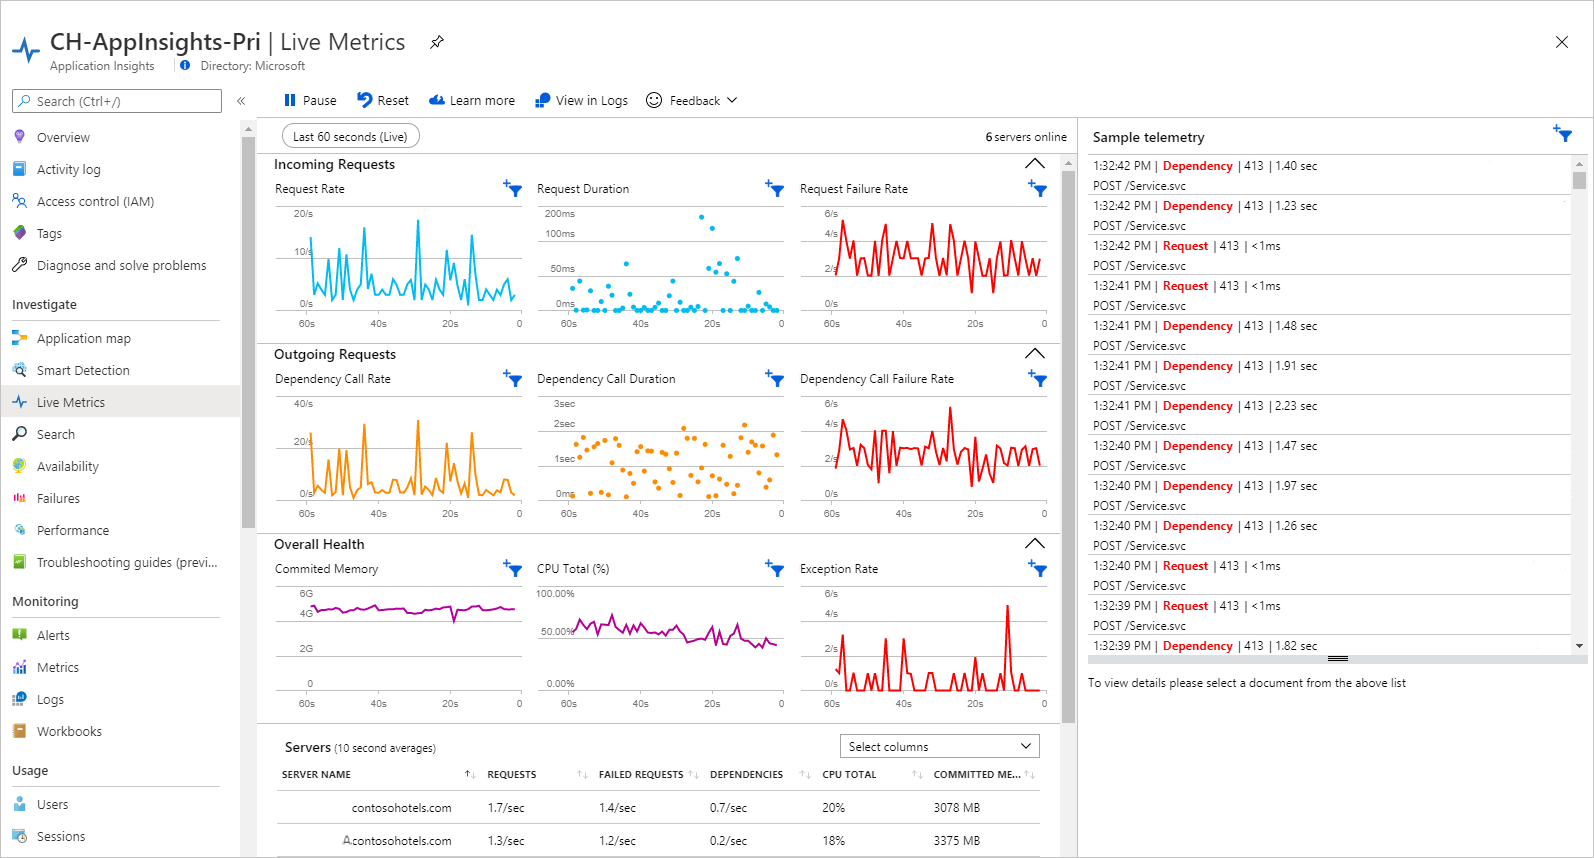
Application Insights – kluczowa telemetria
- Żądania (Requests)
- Zależności (Dependencies)
- Wyjątki (Exceptions)
- Testy dostępności
Przykład: błędy 5xx według punktu końcowego
requests
| where success == false
| summarize Failures = count() by name, resultCode
| order by Failures desc
Przykład: awarie zależności (SQL / API)
dependencies
| where success == false
| summarize count() by target, type
Zastosowanie:
- Identyfikowanie niedziałających wywołań SQL, Redis i API
- Odróżnianie problemów aplikacji od problemów platformy
Przykład: wolne żądania
requests
| summarize AvgDuration = avg(duration) by name
| order by AvgDuration desc
13. Przykład korelacji end-to-end
Zobacz diagram na learn.microsoft.com
Zobacz diagram na learn.microsoft.com
Typowy przebieg dochodzenia:
- WAF – skok zablokowanego ruchu
- Front Door – wzrost opóźnień
- App Service – przekroczenie limitu czasu zależności
- Application Insights – wolne zapytanie SQL
- Działanie – skalowanie App Service / dostrojenie WAF / naprawa indeksu bazy danych
14. Zalecane ustawienia diagnostyczne (najlepsza praktyka)
| Zasób | Wysyłaj dzienniki do | Retencja |
|---|---|---|
| WAF | Log Analytics | 30–90 dni |
| Front Door | Log Analytics | 30–90 dni |
| App Service | App Insights + LA | 30 dni |
| Metryki | Azure Monitor | Domyślnie |
| Archiwum | Storage Account | 1–7 lat |
15. Podsumowanie – dlaczego to ważne
Przy prawidłowo skonfigurowanym Azure Monitor:
- WAF pokazuje atak a fałszywy alarm
- Front Door pokazuje kondycję brzegu sieci i routingu
- App Service pokazuje zachowanie aplikacji
- Application Insights pokazuje prawdę na poziomie kodu
Razem zapewniają pełną widoczność od brzegu sieci → aplikacji → zależności.