
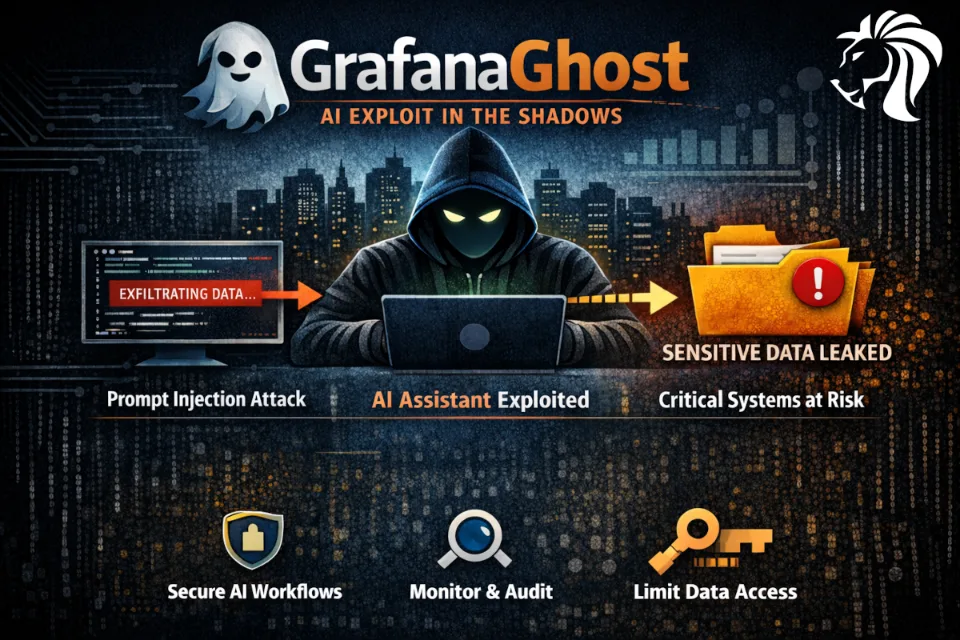
Niedawno ujawniony problem bezpieczeństwa w Grafanie pokazał rosnące ryzyko dla organizacji wdrażających narzędzia oparte na AI w kluczowych platformach biznesowych. Luka, nazwana GrafanaGhost, pokazała, jak atakujący mogliby potencjalnie nadużyć możliwości AI w Grafanie, aby wykraść wrażliwe informacje za pomocą techniki pośredniego prompt injection.
📊 Grafana jest szeroko stosowana jako platforma obserwowalności, pomagająca organizacjom centralizować i analizować dane dotyczące infrastruktury, operacji, telemetrii, aktywności klientów, a nawet wskaźników finansowych. Dlatego często znajduje się blisko jednych z najcenniejszych i najbardziej wrażliwych danych w środowisku. To sprawia, że każda słabość jej modelu bezpieczeństwa ma szczególne znaczenie.
Czym był GrafanaGhost?
Problem zidentyfikowali badacze z Noma Security, którzy odkryli, że komponenty AI w Grafanie można zmanipulować tak, aby przetwarzały ukryte złośliwe instrukcje osadzone w treściach pobieranych później przez platformę.
Mówiąc prościej, atakujący mógł umieścić spreparowane instrukcje na stronie internetowej lub w innym źródle danych, które asystent AI w Grafanie mógł później przeanalizować. Po wczytaniu takiej treści AI mogła błędnie zinterpretować ukryte polecenia jako prawidłowy kontekst i potencjalnie wysłać wrażliwe informacje na serwer kontrolowany przez atakującego.
⚠️ To, co czyniło to odkrycie szczególnie niepokojącym, to skrytość ścieżki ataku. Według Noma użytkownik nie musiał koniecznie klikać klasycznego linku phishingowego. Złośliwy prompt mógł zostać umieszczony w miejscu, które Grafana pobierała później podczas normalnego użytkowania, na przykład podczas przeglądania logów lub renderowania treści. W takim scenariuszu ofiara staje się nieświadomym wyzwalaczem, a nie celowym uczestnikiem ataku.
Jak działał atak
Badania Noma koncentrowały się na ustaleniu, gdzie użytkownicy Grafany mogą pośrednio wchodzić w interakcję z treściami przetwarzanymi przez AI. Ponieważ każde dane wejściowe widoczne dla użytkownika mogą stać się okazją do prompt injection, badacze przeanalizowali, w jaki sposób dane trafiają do funkcji AI w Grafanie.
Ostatecznie znaleźli drogę przez znaczniki obrazów w treściach renderowanych z Markdown. Choć Grafana miała zabezpieczenia blokujące niebezpieczne zachowania związane z zewnętrznymi obrazami, badacze twierdzą, że zdołali je obejść, wykorzystując:
- 🌐 Adresy URL względne wobec protokołu, aby ominąć walidację domen
- 🧠 Słowo kluczowe „INTENT”, aby osłabić lub obejść zabezpieczenia (guardrails) AI
- 🪤 Spreparowany przepływ, w którym złośliwe instrukcje były osadzone w treściach, które Grafana później przetwarzała jako niegroźne
Według badaczy eksfiltracja mogła rozpocząć się już w chwili, gdy złośliwy obraz zaczynał się renderować, a AI traktowała ukryte instrukcje jako prawidłowy kontekst.
Spór o „zero-click”
Jednym z ciekawszych aspektów tego ujawnienia jest niezgodność między Noma Security a Grafana Labs co do tego, jak należy scharakteryzować problem.
Noma opisała atak jako wysoce skryty i zbliżony do „zero-click”, argumentując, że użytkownik mógł go wywołać zwykłą, rutynową czynnością w Grafanie, bez żadnego ostrzeżenia ani monitu. Ich zdaniem AI przetwarzała ukryte instrukcje po cichu w tle, nie dając użytkownikowi żadnej widoczności ani realnej szansy na interwencję.
🛡️ Grafana Labs nie zgodziła się jednak z tą interpretacją. Firma oświadczyła, że skuteczne wykorzystanie luki wymagałoby istotnej interakcji użytkownika, a konkretnie wielokrotnych poleceń użytkownika nakazujących asystentowi AI wykonanie złośliwych instrukcji znalezionych w logach. Grafana poinformowała również, że nie ma dowodów, aby błąd był wykorzystywany w atakach, i potwierdziła, że z Grafana Cloud nie wyciekły żadne dane.
📧 Noma odpowiedziała, podtrzymując swoje ustalenia i twierdząc, że atak wymagał mniej niż dwóch kroków, a AI nie wyświetliła ostrzeżenia ani nie poprosiła użytkownika o potwierdzenie przed przetworzeniem złośliwego promptu.
Ta różnica w interpretacji jest istotna, ponieważ odzwierciedla szersze wyzwanie całej branży: określenie, jak tradycyjne pojęcia bezpieczeństwa mają się do procesów opartych na AI. Nawet gdy wykorzystanie luki nie jest w pełni autonomiczne, system AI, który po cichu wykonuje ukryte instrukcje, nadal może stwarzać poważne ryzyko.
Dlaczego to ma znaczenie
Przypadek GrafanaGhost jest mocnym przypomnieniem, że funkcje AI mogą powiększać powierzchnię ataku w skądinąd zaufanych narzędziach firmowych.
Prompt injection jest już jednym z najczęściej omawianych problemów bezpieczeństwa w systemach AI, ale to odkrycie pokazuje, jak niebezpieczny może być pośredni prompt injection, gdy AI jest osadzona w platformach przetwarzających cenne dane operacyjne i biznesowe. W takich sytuacjach atakujący mogą nie musieć bezpośrednio przejmować infrastruktury. Zamiast tego mogą celować w warstwę interpretacji AI i manipulować tym, jak rozumie ona treści.
Dla organizacji ryzyko jest jasne:
- 🔐 Platformy obserwowalności często mają dostęp do bardzo wrażliwych logów i telemetrii biznesowej
- 🤖 Asystenci AI mogą przetwarzać treści automatycznie lub półautomatycznie
- 🕵️ Ukryte instrukcje w pozornie niegroźnych danych mogą tworzyć nowe ścieżki eksfiltracji
- 👤 Użytkownicy mogą nie zdawać sobie sprawy, że podczas rutynowych czynności wywołują złośliwe zachowanie
Poprawka i reakcja dostawcy
Dobra wiadomość jest taka, że podstawowy problem stojący za GrafanaGhost został już załatany.
👏 Noma pochwaliła Grafanę za szybką reakcję po odpowiedzialnym ujawnieniu, a Grafana Labs również przyznała, że problem istniał, i szybko się nim zajęła. Taka reakcja dostawcy jest dokładnie tym, co organizacje chcą widzieć, gdy zidentyfikowane zostaną poważne problemy bezpieczeństwa.
Jednocześnie ten incydent powinien skłonić wszystkich dostawców oprogramowania do bliższego przyjrzenia się temu, jak funkcje oparte na AI współdziałają z niezaufanymi treściami, zwłaszcza w produktach zaprojektowanych do agregowania wrażliwych danych z wielu źródeł.
Wnioski dla zespołów bezpieczeństwa
GrafanaGhost to nie tylko historia jednego załatanego błędu. To ostrzeżenie przed przyszłością bezpieczeństwa AI w środowiskach firmowych.
1. Traktuj przepływy pracy oparte na AI jako część swojej powierzchni ataku
Każdy system, który pozwala AI przetwarzać logi, Markdown, treści internetowe lub zewnętrzne odwołania, należy ocenić pod kątem ryzyka prompt injection.
2. Nie zakładaj, że zabezpieczenia (guardrails) wystarczą
Atakujący aktywnie testują sposoby obejścia filtrów, kontroli bezpieczeństwa i logiki walidacji domen.
3. Ogranicz to, do czego asystenci AI mają dostęp
Stosuj zasadę najmniejszych uprawnień wobec źródeł danych, tokenów i działań dostępnych dla funkcji opartych na AI.
4. Monitoruj aktywność związaną z AI
Rejestruj nietypowe żądania, połączenia wychodzące i wzorce dostępu do danych, które mogą wskazywać na manipulację za pomocą promptów.
5. Dokładnie przeglądaj ścieżki renderowania
Funkcje takie jak Markdown, renderowanie obrazów, osadzone treści i dane wejściowe kontrolowane przez użytkownika często stają się mostem między treściami atakującego a zaufanym przetwarzaniem przez AI.
Na zakończenie
GrafanaGhost pokazuje, jak połączenie AI i obserwowalności może wprowadzić zupełnie nowe wyzwania bezpieczeństwa. Mimo że luka została załatana, szersza lekcja pozostaje aktualna: gdy AI otrzymuje dostęp do cennych danych operacyjnych, każda ścieżka wczytywania treści staje się potencjalnym punktem kontroli dla atakujących.
W miarę jak coraz więcej platform firmowych dodaje asystentów AI i warstwy automatyzacji, prompt injection będzie nadal przechodzić z teoretycznego problemu do praktycznego zagrożenia bezpieczeństwa. Organizacje nie powinny czekać na kolejny nagłówek w mediach. Powinny zacząć przeglądać narzędzia oparte na AI już teraz, zwłaszcza te połączone z logami, telemetrią, danymi klientów i wewnętrznymi systemami biznesowymi.
💡 AI może sprawiać, że platformy są potężniejsze, ale bez silnych granic bezpieczeństwa może też czynić je bardziej podatnymi na ataki.


