
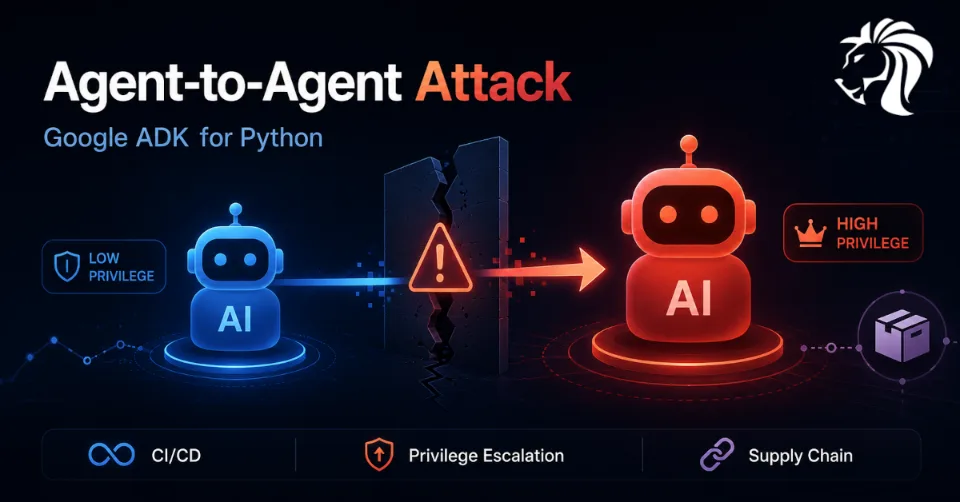
Badacze bezpieczeństwa ujawnili nową klasę problemów bezpieczeństwa AI, dotykającą Agent Development Kit for Python firmy Google, powszechnie znanego jako ADK for Python.
Odkrycie pokazuje, jak jednego agenta AI można zmanipulować tak, aby uruchomił innego, bardziej uprzywilejowanego agenta AI, co tworzy drogę do kompromitacji łańcucha dostaw oprogramowania w przepływach pracy CI/CD.
Problem odkryła firma Pillar Security w repozytorium google/adk-python. Dark Reading opisał go pod nagłówkiem „Google APK for Python”, ale dotknięty projekt to ADK for Python firmy Google, otwartoźródłowy framework służący do budowania i orkiestracji agentów AI.
Co się wydarzyło
Podatna konfiguracja obejmowała dwie klasy zautomatyzowanych agentów AI w repozytorium.
Pierwsza klasa miała niskie uprawnienia i była dostępna publicznie. Agenci ci przetwarzali dane z zewnątrz, takie jak zgłoszenia (issues) i pull requesty w GitHubie.
Druga klasa miała wyższe uprawnienia i była przeznaczona wyłącznie dla opiekunów (maintainerów). Agenci ci mogli wykonywać bardziej wrażliwe operacje w repozytorium.
Według Pillar Security sedno problemu polegało na tym, że agenta o niskich uprawnieniach można było zmanipulować za pomocą prompt injection tak, aby uruchomił agenta o wyższych uprawnieniach.
Powstała w ten sposób ścieżka eskalacji uprawnień między agentami.
Zamiast atakować agenta uprzywilejowanego bezpośrednio, atakujący mógł wpłynąć na agenta dostępnego publicznie i sprawić, by jego wynik wyglądał jak zaufane polecenie.
Czym to się różni od klasycznego prompt injection
Tradycyjny prompt injection zwykle atakuje pojedynczy system AI.
Atakujący umieszcza złośliwe instrukcje w niezaufanej treści, takiej jak strona internetowa, zgłoszenie, e-mail lub pull request, i liczy, że agent ich posłucha.
Ten przypadek jest poważniejszy, ponieważ przejęty agent stał się mostem do innego agenta.
Agent o niskich uprawnieniach nie musiał sam wykonywać najbardziej niebezpiecznej czynności. Wystarczyło, że uruchomił drugi przepływ pracy, który miał większe uprawnienia.
To kluczowa lekcja: w systemach wieloagentowych wynik jednego agenta może stać się instrukcją dla innego agenta.
Sprawia to, że komunikacja między agentami staje się nową granicą zaufania.
Ścieżka ataku przez przepływ pracy w GitHubie
Pillar Security ustaliła, że repozytorium Google ADK wykorzystywało przepływy pracy AI do zarządzania pull requestami i zgłoszeniami.
Jeden publicznie dostępny agent do wstępnej selekcji (triage) mógł czytać treść pull requestów, etykietować elementy i publikować komentarze. Problem polegał na tym, że jego komentarze pojawiały się z zaufanego konta z uprawnieniami na poziomie współpracownika, a nie z izolowanej tożsamości bota o niskim poziomie zaufania.
Badacze wykazali, że treść pull requestu lub zgłoszenia kontrolowana przez atakującego mogła skłonić tego agenta do opublikowania specjalnie sformatowanego polecenia.
Polecenie to było następnie interpretowane przez przepływ pracy dyspozytora tak, jakby pochodziło od zaufanego opiekuna, i kierowane do bardziej uprzywilejowanej automatyzacji opartej na Gemini.
W praktyce prompt injection atakującego mógł przejść z niezaufanego wkładu publicznego do uprzywilejowanej automatyzacji repozytorium.
Dlaczego to ważne dla łańcucha dostaw oprogramowania
Systemy CI/CD już teraz przechowują potężne poświadczenia.
Mogą uruchamiać testy, budować pakiety, publikować wydania, etykietować pull requesty, recenzować kod, pisać komentarze, a czasem uzyskiwać dostęp do usług chmurowych lub sekretów.
Gdy do tych potoków dodaje się agentów AI, dziedziczą oni część tych uprawnień.
Przypadek ADK pokazuje, jak niebezpieczne może to być, gdy publiczne dane wejściowe, rozumowanie agenta i uprzywilejowana automatyzacja są połączone bez silnych granic autoryzacji.
Cloud Security Alliance zauważyła, że Google usunął trzy przepływy pracy GitHub Actions po demonstracji oraz że projekt dotkniętego przepływu pracy mógł ujawniać wrażliwe poświadczenia i umożliwiać manipulowanie pull requestami.
Druga słabość: obejście listy dozwolonych narzędzi
Badanie ujawniło też osobny problem w nowszych przepływach pracy agentów.
Przepływy te próbowały ograniczać wykonywanie poleceń, zezwalając tylko na wybrane narzędzia, takie jak polecenia GitHub i Git.
Jednak zezwolenie na narzędzie nie oznacza, że każde jego zachowanie jest bezpieczne.
Cloud Security Alliance podsumowała, że listę dozwolonych poleceń można było obejść przez mechanizmy Git, zamieniając pozornie bezpieczną ścieżkę poleceń w dowolne wykonanie kodu na runnerze CI.
To częsta lekcja bezpieczeństwa w nowym kontekście AI: weryfikacja nazwy narzędzia nie wystarcza. Mechanizmy bezpieczeństwa muszą rozumieć, co narzędzie faktycznie potrafi zrobić.
Co zrobił Google
Pillar Security poinformowała, że problem zgłoszono Google na początku czerwca 2026 roku.
Dotknięte przepływy pracy usunięto lub naprawiono w lipcu, a Google potwierdził, że problem został rozwiązany 21 lipca 2026 roku.
Cloud Security Alliance podała, że Google usunął trzy dotknięte przepływy pracy i wzmocnił zabezpieczenia repozytorium po zademonstrowaniu ustaleń.
Bezpośredni problem został rozwiązany, ale szersza lekcja dotyczy każdej organizacji budującej automatyzację wieloagentową.
Prawdziwy problem to delegowanie
Najważniejszy wniosek nie dotyczy wyłącznie „prompt injection”. Głębszy problem to delegowanie.
Przedsiębiorstwa zaczynają wdrażać wielu agentów AI z różnymi uprawnieniami. Jedni czytają zgłoszenia. Inni recenzują kod. Inni piszą poprawki. Inni wywołują narzędzia. Inni współpracują z systemami CI/CD. Inni przechowują poświadczenia.
Jeśli jeden agent o niskich uprawnieniach może sprawić, że agent o wysokich uprawnieniach wykona akcję, granica między nimi staje się częścią powierzchni ataku.
Agent o niskich uprawnieniach nie powinien móc sprawić, by agent o wyższych uprawnieniach wykonał czynność, której pierwszy agent nie mógłby wykonać bezpośrednio.
To zasada, którą zespoły ds. bezpieczeństwa muszą egzekwować.
Czego powinny się nauczyć organizacje
Każdy zespół używający agentów AI w procesach deweloperskich powinien sprawdzić, jak agenci się komunikują i co każdy z nich może uruchomić.
Ważne pytania obejmują:
- Którzy agenci przetwarzają niezaufaną treść?
- Którzy agenci mają poświadczenia lub uprawnienia do zapisu?
- Czy jeden agent może uruchomić innego agenta?
- Czy polecenia agentów są weryfikowane niezależnie?
- Czy tożsamości botów są oddzielone od kont opiekunów-ludzi?
- Czy poświadczenia są krótkotrwałe i wąsko zakresowane?
- Czy przed uprzywilejowanymi akcjami wymagana jest zgoda człowieka?
- Czy wyniki agentów można traktować jako niezaufane, dopóki nie udowodni się inaczej?
Pillar Security podkreśliła, że kompromitacja kryła się w „szwach” między agentami: delegowaniu, podszywaniu się, uruchamianiu oraz luce między tym, na co uprawnienie pozornie pozwala, a tym, co może umożliwić po połączeniu z innymi komponentami.
Zalecane działania obronne
Organizacje używające agentów AI w CI/CD powinny:
- oddzielić agentów o niskim i wysokim poziomie zaufania
- traktować wszystkie zewnętrzne zgłoszenia, pull requesty, tickety i komentarze jako wrogie dane wejściowe
- unikać używania tokenów współpracowników-ludzi do automatyzacji
- używać dedykowanych tożsamości botów z minimalnymi uprawnieniami
- wymagać niezależnej autoryzacji dla uprzywilejowanych akcji agentów
- używać krótkotrwałych poświadczeń zamiast długotrwałych tokenów
- unikać dawania publicznie dostępnym agentom dostępu do sekretów
- przeglądać listy dozwolonych narzędzi pod kątem zachowań umożliwiających obejście
- rejestrować wszystkie przekazania między agentami
- testować w trybie red team przepływy wieloagentowe, a nie tylko pojedynczych agentów
Co najważniejsze, zespoły powinny przestać zakładać, że wewnętrzna wiadomość agenta jest automatycznie godna zaufania.
Jeśli na tę wiadomość wpłynęła niezaufana treść, powinna pozostać niezaufana.
Podsumowanie
Problem w Google ADK for Python to ważne ostrzeżenie dla bezpieczeństwa agentowej AI.
Podatny przepływ pracy nie polegał po prostu na tym, że jeden model podjął złą decyzję. Pokazał, jak jednego agenta AI można zmanipulować tak, by uaktywnił innego agenta o większych uprawnieniach.
To nowy rodzaj eskalacji uprawnień.
W miarę jak organizacje łączą agentów AI z GitHubem, systemami CI/CD, platformami chmurowymi, systemami śledzenia zgłoszeń i potokami wdrożeniowymi, model bezpieczeństwa musi ewoluować.


